cet exercice est originellement proposé ici:
imports
import numpy as np
import pandas as pd
# juste un utilitaire pour regarder le début d'un fichier
def head(filename, nb_lines=5):
with open(filename) as f:
for lineno, line in enumerate(f, 1):
print(f"{lineno:02d}", line, end="")
if lineno >= nb_lines:
breakla source
l’idée est de se mettre en vraie situation; les données qu’on trouve ici ou là sont souvent très sales !
# de prime abord ça a l'air pas trop mal

# NOTE: si vous n'avez pas le module head, ouvrez le fichier dans votre éditeur favori

head("data/television.txt", 10)
01 POIDLOG POIDSF cLT1FREQ cLT2FREQ
02 0.8894218317 4766.8652013 2 1
03 2.3102092815 12381.589746 30 1
04 2.740069772 14685.431344 6 2
05 1.7755447679 9516.0499388 1 1
06 0.7325124103 3925.9075881 3 1
07 1.7583343823 9423.810705 3 1
08 1.6407330347 8793.525107 3 1
09 0.4139788891 2218.7239959 0
10 1.3790330065 7390.9411886 1 1
# sauf que si on le charge: ouh là !

df = pd.read_csv("data/television.txt", sep="\t")
df# et en particulier, ceci n'est pas du tout ce qu'on veut
df.shape(8403, 32)survol de ce qu’il faut faire
le TP comporte plusieurs étapes
enlever les colonnes pleines de vide; pour fixer les idées, nous nettoyons les colonnes qui contiennent seulement des n/a ou des 0
dans le corrigé on va voir deux méthodes
rapide
manuelle: comment on ferait si le nettoyage devait être fait sur un critère plus spécifique; on verra comment faire sur la base d’une fonction qui, pour une colonne, indique si elle doit être gardée ou pas
calculer les valeurs uniques de la colonne
cLT2FREQ; le texte de l’exercice suggère qu’on doit trouver une poignée de valeursà ce stade, combien de lignes ont leur
cLT2FREQnon renseignée ?
combien doit-on avoir de lignes si on nettoie sur cette base ?
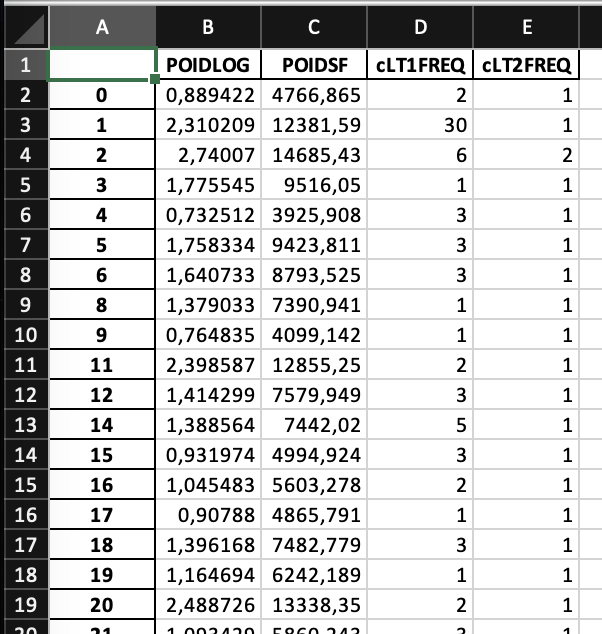
(i.e. si on enlève toutes les lignes qui n’ont pas cette colonne renseignée) faites ce nettoyage et vérifiez votre résultatsauver le résultat dans un fichier excel
toujours pour fixer les idées, on doit trouver à la fin une dataframe qui a une forme de (7386, 4)
indices
je vous signale des fonctions utiles dans tout le TP:
# df.dropna?
# df.drop?

# pd.Series.unique?

# df.to_excel?
# !pip install openpyxl
colonnes vides
la première étape donc, consiste à supprimer les colonnes vides
# on recharge pour être sûr
df = pd.read_csv("data/television.txt", sep="\t")
df.shape
(8403, 32)la méthode rapide
le mieux c’est d’utiliser dropna
# pour voir la doc
# df.dropna?
# à vous
...Ellipsis# ceci doit afficher True
df.shape == (8403, 4)Falsedf.head()la méthode pédestre
dans ce cas précis, dropna est le mieux bien sûr
maintenant, dans certains cas le critère pour ‘oublier’ des colonnes peut être moins simple - imaginez par exemple qu’on veuille supprimer toutes les colonnes qui contiennent un certain pourcentage de valeurs parmi GARBAGE et TRASH et un vrai n/a...
donc voyons comment on peut faire le même nettoyage, mais de manière plus fine
# on recharge pour être sûr
df = pd.read_csv("data/television.txt", sep="\t")en deux étapes:
d’abord comment feriez-vous, étant donné le nom d’une colonne, pour savoir si elle est pleine de vide ?
# à vous
def is_empty_column(df, colname):
...# ceci doit afficher True
# on teste
col1 = 'POIDLOG'
not is_empty_column(df, col1)True# ceci doit afficher True
col5 = 'Unnamed: 4'
is_empty_column(df, col5)ensuite il ne reste qu’à calculer la liste des colonnes vides, pour la passer à df.drop()
# ceci doit afficher True
df.shape == (8403, 4)FalseBien sûr on a découpé le problème en deux mais en fait ça peut se récrire en une seule ligne
# en option

# à vous

# récrire tout ceci en une seule passe
# ceci doit afficher True
df.shape == (8403, 4)Falseobtenir les valeurs distinctes
comment obtenir les valeurs distinctes de la colonne cLT2FREQ
le texte de l’exercice initial nous apprend qu’on ne devrait avoir que 3 valeurs; et une inspection visuelle rapide vous le confirme, plus la présence de pas mal de vide dans cette colonne
la méthode la plus simple consiste à utiliser Series.unique qui renvoie le résultat sous la forme d’un numpy.ndarray
# à vous
uniques = ...uniquesEllipsis# ceci doit afficher True
uniques.sort()
np.all(uniques[:-1] == np.arange(1, 4)) and np.isnan(uniques[-1])---------------------------------------------------------------------------
AttributeError Traceback (most recent call last)
Cell In[22], line 2
1 # ceci doit afficher True
----> 2 uniques.sort()
3 np.all(uniques[:-1] == np.arange(1, 4)) and np.isnan(uniques[-1])
AttributeError: 'ellipsis' object has no attribute 'sort'# point de réflexion : pourquoi ceci ne renvoie-t-il pas True ?
uniques.sort()
np.all(uniques == np.array([1., 2., 3., np.nan]))---------------------------------------------------------------------------
AttributeError Traceback (most recent call last)
Cell In[23], line 2
1 # point de réflexion : pourquoi ceci ne renvoie-t-il pas True ?
----> 2 uniques.sort()
3 np.all(uniques == np.array([1., 2., 3., np.nan]))
AttributeError: 'ellipsis' object has no attribute 'sort'compter les lignes à nettoyer
on veut maintenant nettoyer les données en enlevant les lignes qui n’ont pas la colonne cLT2FREQ renseignée
dans un premier temps on vous demande de calculer le nombre de lignes concernées
# à vous
nb_lines_to_clean = ...
# ceci doit afficher True
nb_lines_to_clean == 1017False# ce qui signifie qu'à la fin on doit avoir ce nombre de lignes
8403-10177386# ou encore, plus proprement
expected_lines = len(df) - nb_lines_to_clean
expected_lines---------------------------------------------------------------------------
TypeError Traceback (most recent call last)
Cell In[27], line 2
1 # ou encore, plus proprement
----> 2 expected_lines = len(df) - nb_lines_to_clean
3 expected_lines
TypeError: unsupported operand type(s) for -: 'int' and 'ellipsis'nettoyage des lignes
option 1: df.drop()
# on recharge à tout hasard
df = pd.read_csv("data/television.txt", sep="\t").dropna(axis='columns', how='all')
print(df.shape)
(8403, 4)
remarquez que df.drop prend un paramètre optionnel inplace qui peut être souvent utile
#df.drop?option 1: on peut utiliser df.drop(), l’avantage étant qu’on peut faire l’opération en place
# à vous

# df.drop(...)
# ceci doit afficher True
# la forme après nettoyage
df.shape == (7386, 4)Falseoption 2: sélection avec un masque et []
# on recharge à tout hasard
df = pd.read_csv("data/television.txt", sep="\t").dropna(axis='columns', how='all')
print(df.shape)
(8403, 4)
option 2: il y a plein d’autres façons de faire, on peut aussi utiliser tout simplement un masque
# à vous
# df = ...
# ceci doit afficher True
# la forme après nettoyage
df.shape == (7386, 4)Falsesauver un fichier excel
je vous laisse conclure le TP, il s’agit d’enregistrer nos données nettoyées dans un fichier excel
je vous laisse éventuellement vérifier votre code en rechargeant sous excel le fichier produit